Audyt SEO to przegląd techniczny, treściowy i linkowy strony zakończony listą błędów blokujących widoczność w Google i AI. Poradnik dla właściciela strony i początkującego SEO-wca: 9 kroków w darmowych narzędziach (Google Search Console, Screaming Frog), od indeksacji, przez Core Web Vitals i on-page, po widoczność w AI search.
Poradnik jest dla właściciela strony i początkującego SEO-wca, który chce przejrzeć stronę sam, darmowymi narzędziami. Dane, nazwy raportów i ceny w poradniku są aktualne na październik 2026.
Przed publikacją zrobiłem według tych 9 kroków audyt bynajmniej.pl (14.10.2026: crawl Screaming Frog na 441 wewnętrznych URL-ach i URL Inspection w GSC dla 84 URL-i z sitemap). Wyniki tego audytu podaję w krokach jako przykłady.
Audyt SEO w skrócie: zakres i 9 kroków
Google nie publikuje definicji audytu SEO, a dokumentacja Google Search Central „Do I need an SEO?” wśród usług SEO wymienia przegląd treści i struktury strony, porady techniczne, research słów kluczowych i optymalizację pod generatywną AI. W 2026 roku polskie agencje dopisują do zakresu audytu sprawdzanie cytowań w narzędziach AI.
Samodzielny przegląd strony obejmuje 9 kroków, od indeksacji w Google Search Console do widoczności w AI search:
- Indeksacja w Google Search Console: raport Indeksowanie stron i Narzędzie do sprawdzania adresów URL.
- Sterowanie crawlowaniem: robots.txt, noindex, canonical i sitemapy XML.
- Crawl strony: kody HTTP, przekierowania i pozorne błędy 404.
- Core Web Vitals: LCP, INP i CLS z danych polowych.
- HTTPS i wersja mobilna strony.
- On-page: title, meta description, nagłówki, alt i linkowanie wewnętrzne.
- Dane strukturalne i hreflang.
- Ręczne działania, problemy z bezpieczeństwem i profil linków.
- Widoczność w AI search: raporty AI w GSC i Bingu oraz tokeny botów AI w robots.txt.
Narzędzia do audytu SEO w 2026 roku
Narzędzia potrzebne do samodzielnego przeglądu strony są w większości darmowe. Moim zdaniem Google Search Console i darmowy Screaming Frog wystarczą do audytu strony firmowej, a abonament ma sens przy analizie konkurencji.
| Narzędzie | Do czego w audycie SEO | Koszt (październik 2026) |
|---|---|---|
| Google Search Console | indeksacja, sitemapy, Core Web Vitals, HTTPS, ręczne działania, raporty AI | bezpłatne |
| PageSpeed Insights | dane polowe CrUX z 28 dni i test Lighthouse | bezpłatne |
| Lighthouse | performance, accessibility, best practices, SEO; zastępuje wycofany Mobile-Friendly Test | bezpłatne |
| Screaming Frog SEO Spider | crawl: kody HTTP, title, nagłówki, linki | do 500 URL-i bez opłat; licencja £199 / €245 / $279 rocznie |
| Ahrefs Webmaster Tools | Site Audit (170+ problemów), backlinki | bezpłatne dla zweryfikowanych witryn, 5000 kredytów crawla na projekt miesięcznie |
| Bing Webmaster Tools | Site Scan i raport AI Performance | bezpłatne |
| Rich Results Test i Schema Markup Validator | dane strukturalne | bezpłatne |
| Senuto | widoczność, linki, SERP, moduł AI Overviews | od 107,50 zł netto/mies. (plan Lite, rozliczenie roczne), trial 14 dni |
Ceny w tabeli narzędzi pochodzą z cenników Screaming Frog, Ahrefs i Senuto.
Krok 1. Sprawdź indeksację w Google Search Console
Raport Indeksowanie stron w Google Search Console (dawniej „Stan”) pokazuje, które URL-e są poza indeksem i dlaczego. Według pomocy Google do raportu Indeksowanie stron najczęstsze statusy to „Błąd serwera (5xx)”, „URL zablokowany przez plik robots.txt”, „Pozorny błąd 404”, „Strona zeskanowana, ale jeszcze niezindeksowana” i „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”.
Raport Indeksowanie stron czytam od statusów „Strona zeskanowana, ale jeszcze niezindeksowana” (Crawled – currently not indexed) i „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” (Duplicate, Google chose different canonical than user), bo oba statusy dotyczą stron, które Google zna, ale nie indeksuje.
Na bynajmniej.pl URL Inspection pokazał dla 84 URL-i z sitemap: 80 ze statusem „Strona przesłana i zindeksowana”, 2 ze statusem „Strona zeskanowana, ale jeszcze niezindeksowana” (wpisy z ok. 2008–2009), 1 „Błąd przekierowania” i 1 „Adres URL jest Google nieznany”. Stare niezindeksowane wpisy warto odświeżyć albo scalić.
Narzędzie do sprawdzania adresów URL (URL Inspection) w GSC pokazuje wersję zaindeksowaną strony: status, canonical wybrany przez Google i dane strukturalne. Test opublikowanego adresu URL (Test live URL) pokazuje stronę wyrenderowaną przez Google-InspectionTool. Według dokumentacji URL Inspection prośba o zindeksowanie (Request indexing) nie gwarantuje indeksacji, a narzędzie ma dzienne limity na usługę.
Krok 2. Sprawdź robots.txt, noindex, canonical i sitemapy
Plik robots.txt steruje crawlowaniem, a nie indeksacją. Według specyfikacji robots.txt w Google Search Central plik ma limit 500 KiB, treść powyżej limitu jest ignorowana, a Google trzyma robots.txt w cache zwykle do 24 godzin. URL zablokowany w robots.txt może trafić do indeksu bez treści i bez opisu, jeśli prowadzą do niego linki.
Reguła noindex działa tylko w tagu <meta name="robots" content="noindex"> albo w nagłówku HTTP X-Robots-Tag: noindex. Dokumentacja Google o blokowaniu indeksowania mówi wprost, że Google nie obsługuje reguły noindex w pliku robots.txt (w dokumentacji Google po angielsku: „Specifying the noindex rule in the robots.txt file is not supported by Google”). Strona z noindex nie może być zablokowana w robots.txt, bo Googlebot nie zobaczy wtedy reguły noindex.
Canonical sprawdzasz pod kątem sygnałów, które Google waży różnie. Według poradnika Google o konsolidacji duplikatów przekierowanie i rel="canonical" to „silny sygnał”, a obecność URL-a w sitemapie to „słaby sygnał”. Robots.txt nie służy do kanonizacji.
Sitemapa XML mieści maksymalnie 50 MB (bez kompresji) albo 50 000 URL-i, a większe zbiory dzieli się na kilka plików spiętych indeksem map witryn. Google ignoruje znaczniki <priority> i <changefreq>. Raport Mapy witryn w GSC nie pokazuje sitemap wykrytych przez robots.txt, więc sitemapę zgłaszam w GSC ręcznie.
Na bynajmniej.pl dwa URL-e w sitemapie zwracają 301 (/podcast/ i /wordpress-seo/), a /wordpress-seo/ ma w GSC status „Błąd przekierowania”. Przekierowanie było odwrócone: nowszy wpis kierował na starszą kopię z 2008 roku. Po audycie przywróciłem /wordpress-seo/ i napisałem go od nowa jako poradnik SEO WordPressa na 2026 rok. Dwa wpisy mają canonical na LinkedIn Pulse (celowe cross-posty), więc wersją kanoniczną jest LinkedIn. Przekierowane adresy trzeba usunąć z sitemapy.
Krok 3. Zrób crawl i sprawdź kody HTTP
Crawl strony robisz Screaming Frogiem (do 500 URL-i bez opłat) albo Site Auditem w Ahrefs Webmaster Tools (5000 kredytów crawla miesięcznie).
Kody HTTP w crawlu sprawdzasz pod kątem pięciu zasad z dokumentacji Google o błędach HTTP i sieci: wagi przekierowań, traktowania błędów 4xx, wpływu błędów 5xx, limitu przekierowań w łańcuchu i pozornych błędów 404 (soft 404).
- Przekierowania 301 i 308 są silnym sygnałem, że cel przekierowania ma zostać kanonicznym; 302 i 307 są sygnałem słabym.
- Błędy 404 i 410 Google traktuje tak samo: „wszystkie błędy 4xx, z wyjątkiem 429, są traktowane jednakowo”.
- Błędy 5xx i kod 429 tymczasowo spowalniają crawlowanie.
- Googlebot podąża za maksymalnie 10 przekierowaniami w łańcuchu.
- Pozorny błąd 404 (soft 404) to strona z kodem 2xx, która wygląda na błąd (pusta albo z komunikatem błędu).
Googlebot dla wyszukiwarki przetwarza pierwsze 2 MB pliku HTML (po dekompresji), co podaje strona dokumentacji Googlebota. Raport Statystyki indeksowania w Ustawieniach GSC przy stronach poniżej ok. 1000 podstron moim zdaniem można pominąć, bo Google pisze, że takie witryny „zasadniczo go nie potrzebują”.
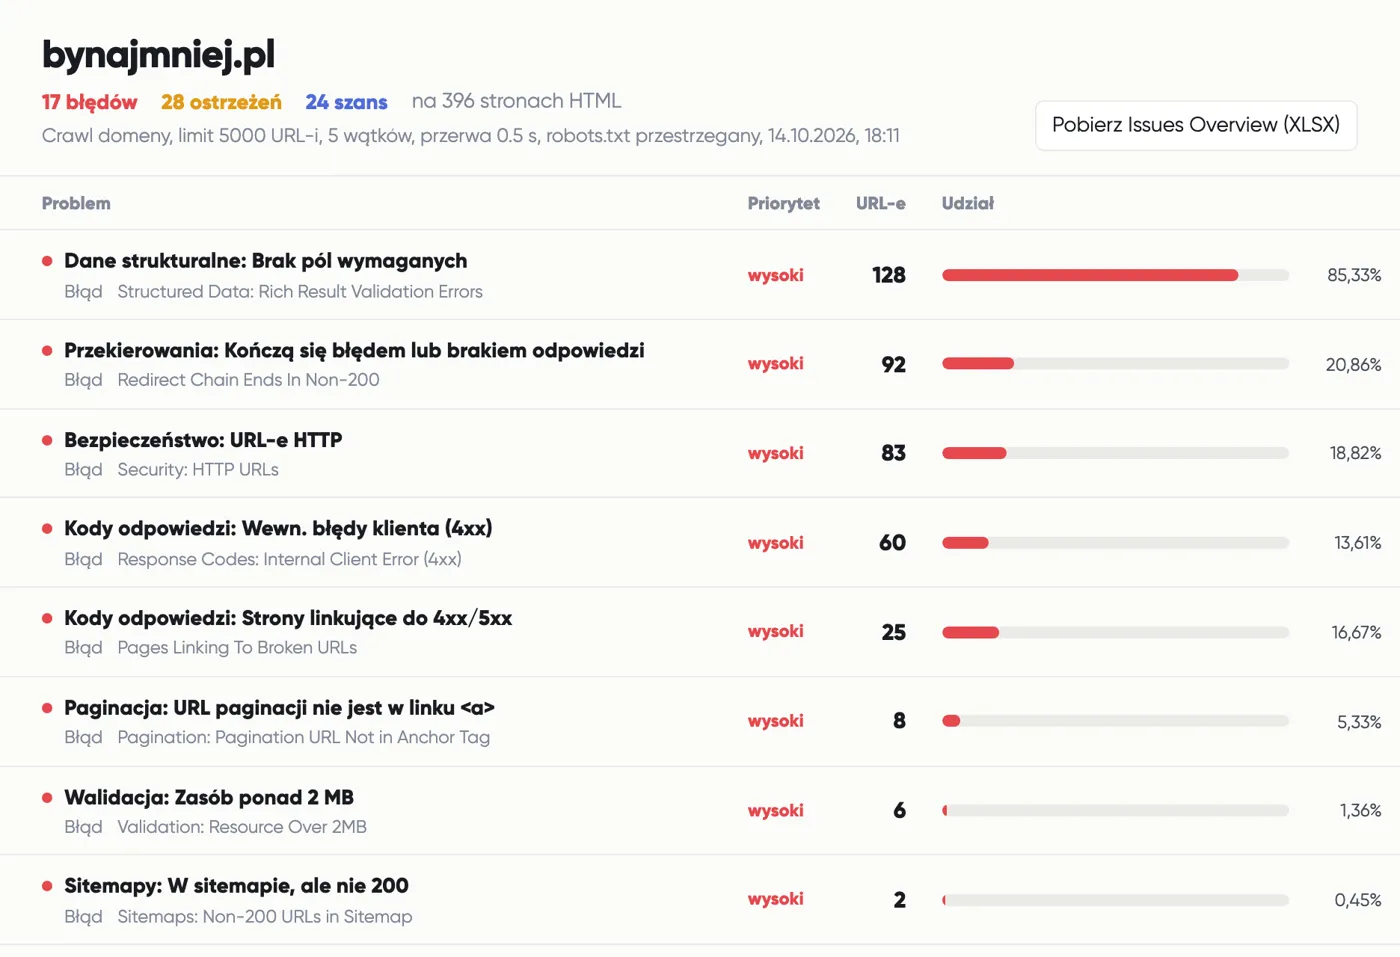
Na bynajmniej.pl crawl Screaming Frog znalazł 60 wewnętrznych URL-i z kodem 4xx, głównie obrazki z wpisów z lat 2008–2009, oraz 186 przekierowań 3xx, z czego 61 to łańcuchy. Linki w treści do takich adresów trzeba podmienić albo usunąć.
Krok 4. Zmierz Core Web Vitals
Core Web Vitals to trzy metryki: LCP (ładowanie), INP (reakcja na interakcję) i CLS (stabilność układu). INP zastąpił FID jako Core Web Vital 12 marca 2024 roku. Progi z raportu Core Web Vitals w GSC są takie:
| Metryka Core Web Vitals | Dobry | Do poprawy | Słaby |
|---|---|---|---|
| LCP (Largest Contentful Paint) | ≤ 2,5 s | ≤ 4 s | > 4 s |
| INP (Interaction to Next Paint) | ≤ 200 ms | ≤ 500 ms | > 500 ms |
| CLS (Cumulative Layout Shift) | ≤ 0,1 | ≤ 0,25 | > 0,25 |
Raport Core Web Vitals w GSC używa danych polowych z CrUX za 28 dni, osobno dla mobile i desktop. Próg musi spełniać 75% wizyt, status grupy URL-i wyznacza najgorsza metryka, a walidacja poprawki trwa 28 dni. Wynik Lighthouse w PageSpeed Insights traktuję więc jako wskazówkę, a dane polowe CrUX jako ocenę.
Core Web Vitals według dokumentacji Google o page experience „są używane przez systemy rankingowe” Google, ale dobre wyniki nie gwarantują pierwszych pozycji.
Na bynajmniej.pl 6 obrazków ma ponad 2 MB, m.in. pliki PNG wygenerowane w ChatGPT w 2025 roku po 2,5–3,7 MB. Takie obrazki kompresuje się w pierwszej kolejności.
Krok 5. Sprawdź HTTPS i wersję mobilną
Raport HTTPS w Google Search Console liczy zaindeksowane URL-e HTTP i HTTPS. Pomoc Google do raportu HTTPS wymienia typowe błędy: canonical wskazujący wersję HTTP, nieprawidłowy certyfikat, adresy HTTP w sitemapie i przekierowanie HTTPS→HTTP.
Wersja mobilna strony jest wersją, którą Google indeksuje: „w przypadku większości witryn Google indeksuje przede wszystkim wersję mobilną treści”. Mobile-Friendly Test Google wycofał 1 grudnia 2023 roku, więc wersję mobilną sprawdzam w Lighthouse i w teście opublikowanego adresu URL w GSC.
Krok 6. Przejrzyj title, nagłówki i linkowanie wewnętrzne
Title i meta description według Google nie mają limitu znaków. Dokumentacja Google o linkach tytułowych mówi, że długość elementu <title> „nie ma limitu”. SEO Starter Guide zaleca title „inny na każdej stronie, jasny i zwięzły” i meta description „krótki i przypisany do jednej konkretnej strony”. Google nie używa meta keywords.
Na bynajmniej.pl meta description brakuje na 122 ze 150 indeksowalnych stron (81%), a 8 stron ma zduplikowany title. Zduplikowany title łamie zasadę Google „inny na każdej stronie”.
Nagłówki H1–H6 według SEO Starter Guide mogą występować poza kolejnością, a Google pisze, że kolejność nagłówków „nie ma znaczenia”. Ostrzeżenie crawlera o kilku H1 traktuję więc jako informację, nie błąd.
Linkowanie wewnętrzne Google crawluje tylko przez linki <a href>, a anchor ma opisywać cel linku. Dokumentacja Google o linkach podaje zasadę: „każda ważna dla ciebie strona powinna mieć link z co najmniej jednej innej strony w witrynie”. W badaniu SE Ranking na 418 125 audytach (marzec 2025) strony bez przychodzących linków wewnętrznych wykazało 69,32% audytów.
Brak atrybutu alt obrazków to częsty błąd on-page: Ahrefs w badaniu 1 002 165 domen (2023) wykrył go w 80,4% domen, a SE Ranking w 74,43% audytów.
Krok 7. Zweryfikuj dane strukturalne i hreflang
Dane strukturalne Google zaleca wdrażać w formacie JSON-LD i testować w Rich Results Test, a zgodność ze schema.org sprawdza Schema Markup Validator (validator.schema.org). Wytyczne Google zastrzegają, że poprawne dane strukturalne nie gwarantują wyników rozszerzonych.
Na bynajmniej.pl JSON-LD z Yoast SEO jest na wszystkich 150 stronach, a na 128 stronach jest dodatkowo microdata z flagą „brak pól wymaganych” w crawlu. Microdata bez wymaganych pól to pozycja do sprawdzenia w Rich Results Test.
Wyniki rozszerzone FAQ Google przestał wyświetlać w 2026 roku: zapowiedź padła 8 maja 2026, a dokumentację usunięto 15 czerwca 2026 (rejestr zmian Google Search Central). Moim zdaniem schema FAQ nie powinna być w raporcie pozycją „do wdrożenia” pod rich snippety.
Hreflang według dokumentacji Google o wersjach językowych wymaga linków zwrotnych: jeśli dwie strony nie wskazują na siebie nawzajem, Google ignoruje tagi hreflang.
Krok 8. Sprawdź ręczne działania, bezpieczeństwo i profil linków
Raport Ręczne działania w GSC pokazuje kary nałożone przez ludzi z Google za naruszenie zasad dotyczących spamu. Pomoc Google do ręcznych działań wymienia m.in. nienaturalne linki, thin content, keyword stuffing, cloaking i site reputation abuse. Po naprawie wysyłasz prośbę o ponowne rozpatrzenie (Request Review), które trwa zwykle „kilka dni lub tygodni”.
Raport Problemy z bezpieczeństwem w GSC obejmuje hacked content, malware i social engineering. Google radzi oglądać zainfekowane strony przez URL Inspection albo cURL, a nie w przeglądarce.
Profil linków bez opłat sprawdzasz w Site Explorerze Ahrefs Webmaster Tools (do 1000 backlinków naraz): domeny linkujące, anchory i linki, które mogą skończyć się ręcznym działaniem.
Krok 9. Zrób audyt widoczności w AI search
Krok 9 sprawdza, czy strona może być źródłem w AI Overviews, AI Mode, ChatGPT, Perplexity i wyszukiwaniu Claude’a. Według dokumentacji Google o funkcjach AI do AI Overviews i AI Mode „nie ma dodatkowych wymagań technicznych” poza indeksacją i możliwością pokazania snippetu, więc kroki 1–8 są fundamentem audytu pod AI.
Raporty skuteczności generatywnej AI w Google Search Console są nowe: Google ogłosił je 3 czerwca 2026, a do 31 sierpnia 2026 udostępnił je wszystkim witrynom. Raporty AI w GSC pokazują tylko wyświetlenia. Bing Webmaster Tools od 10 lutego 2026 ma w public preview raport AI Performance z liczbą cytowań w Microsoft Copilot i podsumowaniach AI Binga, bez kliknięć.
Przełącznik w GSC wyłączający witrynę z AI Overviews i AI Mode ma poważny skutek: według Google witryny, które się wyłączą, „nie otrzymają ruchu ani wyświetleń z funkcji generatywnej AI” Google. Szymon Słowik (Takaoto) na webinarze Linkhouse z 13.10.2026 radził sprawdzać to ustawienie (u niego: „Generatywna AI w wyszukiwarce”) zwłaszcza na przejętym koncie GSC; dokumentacja Google nazwy menu nie podaje. Token Google-Extended według dokumentacji crawlerów Google nie wpływa na obecność w wyszukiwarce Google.
Tokeny botów AI w robots.txt rozdzielają trening modeli od wyszukiwania: GPTBot i ClaudeBot zbierają treści do treningu, a OAI-SearchBot, Claude-SearchBot i PerplexityBot decydują o widoczności w wyszukiwarkach AI. Funkcje botów opisują OpenAI, Anthropic i Perplexity:
PerplexityBot(Perplexity) pokazuje strony w wynikach Perplexity i według Perplexity nie służy do trenowania modeli;Perplexity-User„zasadniczo ignoruje reguły robots.txt”.ChatGPT-User(OpenAI) pobiera stronę na prośbę użytkownika i według OpenAI reguły robots.txt mogą go nie obejmować.
Blokadę GPTBot czy ClaudeBot uważam za decyzję biznesową, ale blokada OAI-SearchBot, Claude-SearchBot albo PerplexityBot jest moim zdaniem błędem, bo według dostawców wyłącza albo ogranicza widoczność strony w ich wyszukiwarkach. Szymon Słowik (Takaoto) na webinarze Linkhouse z 13.10.2026 przypominał, że bota AI blokuje nie tylko robots.txt: firewall potrafi oddać kod 200 z zaślepką WAF zamiast treści, a większość botów AI nie renderuje JavaScriptu.
Na bynajmniej.pl robots.txt (Yoast SEO) niczego nie blokuje, a GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Googlebot i Bingbot dostają w teście pełną treść (podszyty user agent, wynik orientacyjny). Cała treść jest w HTML bez JavaScriptu, a TTFB wynosi ok. 190 ms.
Treść pod cytowanie w AI audytuje się od początku strony. Michał Suski z Surfera pokazywał na webinarze Linkhouse z 13.10.2026, że w danych AI Trackera Surfera (korelacje, nie eksperymenty) 29% cytowanego tekstu pochodzi z pierwszych 50 słów strony, a statystyki to najsłabiej korelujący element z 20 badanych cech. Google w przewodniku po optymalizacji pod AI dodaje, że Google Search nie używa pliku llms.txt i nie wymaga dzielenia treści na małe fragmenty.
Jak spisać wyniki audytu SEO
Wyniki audytu SEO spisuję jako listę błędów w kolejności wpływu na widoczność: najpierw błędy blokujące indeksację, potem wydajność, potem on-page, na końcu reszta.
- Blokery indeksacji z kroków 1–3: noindex lub blokada robots.txt na ważnych stronach, błędy 5xx, łańcuchy przekierowań, soft 404 i canonical wskazujący zły adres; do tej grupy dopisuję ręczne działania i problemy z bezpieczeństwem z kroku 8.
- Wydajność z kroków 4–5: grupy URL-i ze słabym LCP, INP lub CLS w raporcie Core Web Vitals oraz błędy w raporcie HTTPS.
- On-page z kroku 6: brakujące title i alt oraz strony bez linków wewnętrznych.
- Reszta z kroków 7–9: dane strukturalne, hreflang, profil linków i dostęp botów AI.
Każdy błąd na liście poprawek moim zdaniem powinien mieć trzy pola: raport lub narzędzie, w którym błąd widać, listę URL-i i sposób sprawdzenia poprawki, np. walidację w raporcie Core Web Vitals, która trwa 28 dni.
Czego nie robić w audycie SEO
Checklisty audytu SEO na 100 punktów wyglądają imponująco w PDF-ie, tylko część tych punktów Google ignoruje albo dawno wycofał. Najczęstsze fałszywe alarmy w takich checklistach to długość title i meta description, znaczniki priority w sitemapie, noindex w robots.txt i plik llms.txt, bo Google żadnego z tych elementów nie używa.
Ile kosztuje audyt SEO i ile trwa
Samodzielny przegląd strony darmowymi narzędziami kosztuje tylko czas. Zlecony audyt SEO kosztuje według publicznych cenników polskich agencji (wrzesień–październik 2026) od ok. 2900–3000 zł netto za mały serwis i od ok. 4900 zł netto za sklep internetowy, a duże serwisy wyceniane są wyżej. Freelancer bierze za małą stronę firmową 700–1500 zł (dane giełdy zleceń Zleca.pl za SEO Toolkit). Audyty robimy też w IF.PL, agencji, którą współprowadzę.
Czas realizacji zleconego audytu według tych samych cenników wynosi 5–30 dni roboczych, zależnie od wielkości serwisu.
Źródła cen (stan IX–X 2026): cennik Semgence (mały serwis od 2900 zł, sklep od 4900 zł; 5–30 dni roboczych zależnie od wielkości) i cennik SAMOSEO (3000–6000 zł; 5–30 dni roboczych).
FAQ: najczęstsze pytania o audyt SEO
Jak samemu zrobić audyt SEO?
Samodzielny przegląd strony robisz w Google Search Console, PageSpeed Insights i darmowej wersji Screaming Frog (do 500 URL-i). Kolejność jest stała: indeksacja, kody HTTP, Core Web Vitals, on-page, linki i widoczność w AI.
Ile kosztuje audyt SEO?
Audyt SEO kosztuje według publicznych cenników polskich agencji (wrzesień–październik 2026) od ok. 2900–3000 zł netto za mały serwis i od ok. 4900 zł za sklep, a duże serwisy więcej. Freelancer wycenia małą stronę firmową na 700–1500 zł.
Gdzie mogę uzyskać bezpłatny audyt SEO?
Bezpłatny audyt SEO dają Google Search Console, Site Audit w Ahrefs Webmaster Tools (170+ problemów, 5000 kredytów crawla miesięcznie na projekt) i Site Scan w Bing Webmaster Tools.
Co powinien zawierać audyt SEO?
Audyt SEO powinien zawierać część techniczną (indeksacja, robots.txt, sitemapy, kody HTTP, Core Web Vitals), część on-page (title, nagłówki, linkowanie wewnętrzne, dane strukturalne) i analizę profilu linków. W 2026 roku do zakresu dochodzi dostęp botów AI i raporty AI w Google Search Console.
Czy audyt SEO gwarantuje pierwsze miejsce w Google?
Audyt SEO nie gwarantuje pierwszego miejsca w Google. Dokumentacja Google Search Central mówi wprost, że nikt nie może zagwarantować pierwszej pozycji (w dokumentacji Google po angielsku: „No one can guarantee a #1 ranking on Google”).
Członek zarządu i współwłaściciel agencji IF.PL, w SEO od ponad 20 lat (m.in. Gazeta.pl, Wirtualna Polska, Polska Press). Na bynajmniej.pl piszę z pomocą AI: temat, dane i testy są moje, AI pomaga ubrać to w słowa.
Dodaj komentarz